Ungewöhnliche Stammbäume visualisieren

Im Gramps-Discourse gab es gerade eine Diskussion darüber, wie man eine Familie mit unverheirateten Partnern korrekt darstellen kann (Unmarried parents in GEDCOM - Help - The Gramps Project (Discourse Forum & Mailing List)). Bemängelt wurde, dass diese in manchen Gramps-Darstellungen als „Ehegatten“ bezeichnet werden; im webtrees-Forum gab es kürzlich eine ähnliche Diskussion, weil die Übersetzung in die dänische Sprache nicht zutreffend war (https://www.webtrees.net/index.php/forum/webtrees-help-and-support/40512-parents-shown-as-partners-even-if-they-are-not).

Das führte in der Diskussion im Gramps-Forum dazu, dass GEDCOM generell als ungeeignet angesehen wird, moderne und komplexe Familien zu modellieren. Als moderne Alternative wurde CIDOC CRM vorgeschlagen. Mit diesem Standard aus der Welt der Geschichtswissenschaft und der Archive lassen sich Ereignisse und Beziehungen flexibel modellieren. Was meint ihr? Wie würdet ihr das folgende Szenario in eurem Genealogieprogramm darstellen?

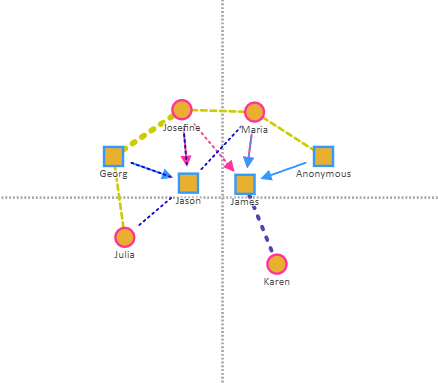
James ist das Ergebnis einer künstlichen Befruchtung. Der Samenspender ist anonym, die Eizellspenderin ist Maria und die Leihmutter, die das Kind ausgetragen hat, ist Karen. Nach James’ Geburt adoptieren Maria und Josefine ihn und werden damit seine rechtlichen Eltern.
Vor dieser Adoption war Josefine mit Georg verheiratet. Aus dieser Ehe stammt Jason, der leibliche Sohn von Josefine und Georg. Jason lebt bis zu seinem sechzehnten Geburtstag im Haushalt von Maria und Josefine. Nach seinem sechzehnten Geburtstag zieht er zu seinem Vater Georg und dessen Partnerin Julia.

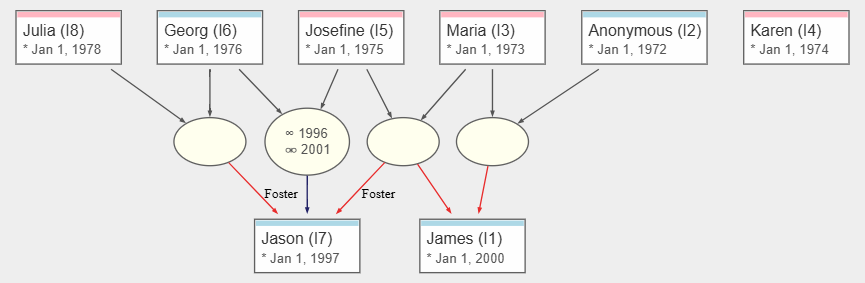
In webtrees habe ich das mit einigen Einschränkungen abgebildet (http://ahnentest.hartenthaler.eu/index.php?route=%2Ftree%2Ffamily_complex) und dann als GEDCOM exportiert. Tatsächlich nicht wirklich schön.
family_complex.ged (2,3 KB)

Hallo Hermann,

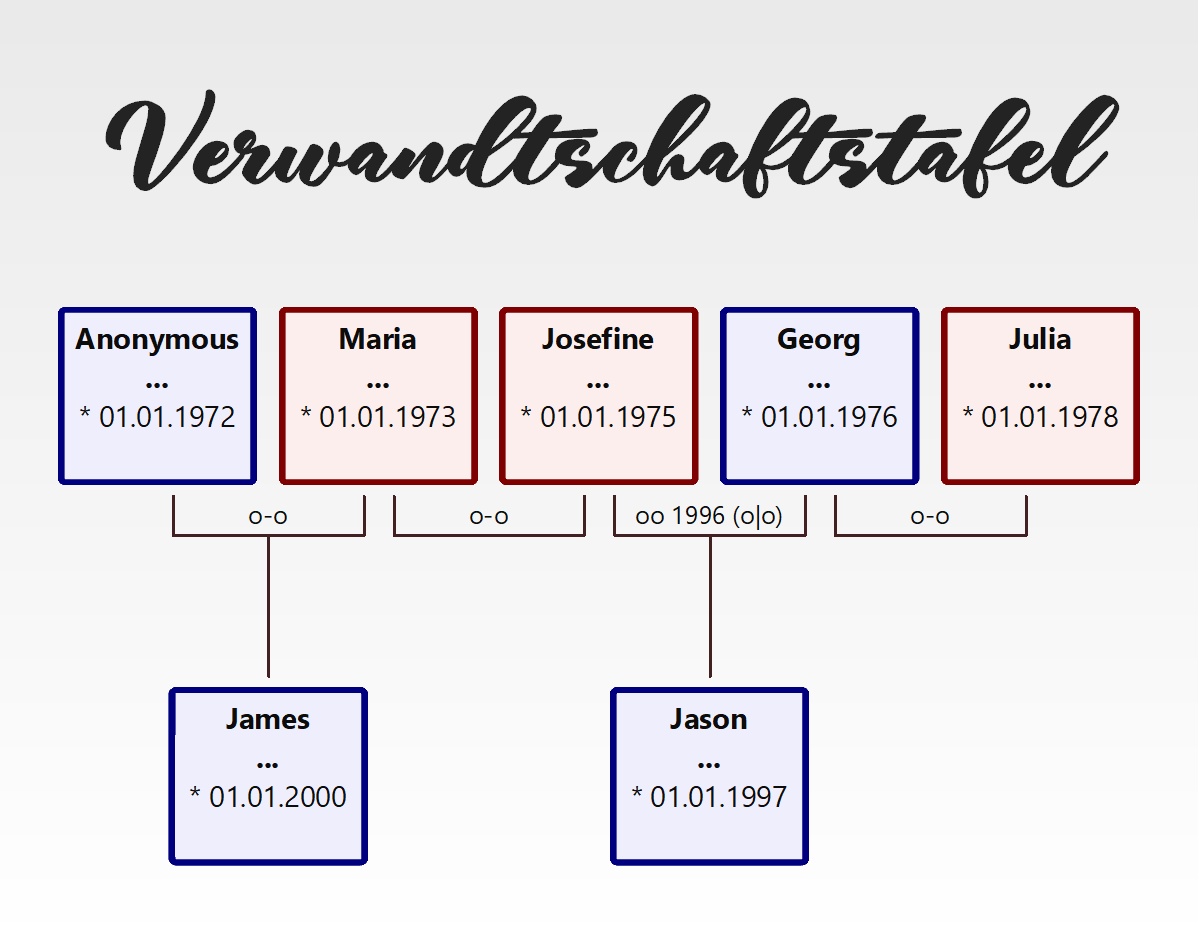
hier mal ein Beispiel, was Ahnenblatt aus deiner GEDCOM-Datei macht:

Bei jeder Person wird nur ein Elternpaar (das bevorzugte) dargestellt. Die nicht mit dem Rest verwandte Karen wird weggelassen.

Ansonsten werden nach meinem Verständnis in der Gramps-Diskussionen zwei Aspekte behandelt.

  1. Wie kann man komplexe Familienzusammenhänge/-beziehungen überhaupt in einer Datenstruktur abbilden?
  2. Wie kann man solche komplexen Familienzusammenhänge grafisch darstellen?

Zu 1.: Hier wird erstaunlicherweise in einem Gramps-Forum nicht Gramps XML, sondern CIDOC CRM als bessere Alternative zu GEDCOM genannt. Ich bin da immer skeptisch, was solche Vorschläge betrifft, solange es keine Genealogie-Software gibt, die das mit einer darauf abgestimmten Benutzeroberfläche nutzt. Irgendwelche Format-Beispiele, die mit einem Texteditor zusammengetippt wurden, beweisen aus meiner Sicht noch nichts. Auch hier wird es sicherlich eine fest definierte Syntax mit festen Schlüsselwörtern geben, damit man den Inhalt auch interpretieren kann, was man bei GEDCOM immer als Ursache für Datenübernahmeprobleme ansieht.

Zu 2.: In der Genealogie werden immer die klassischen Beziehungen Vater/Mutter/Kind verwendet. Das kann man jetzt beklagen, wenn man Beziehungen wie „ist Samenspender von“, „ist Leihmutter von“ oder „hat xy ab dem 5. Lebensjahr großgezogen“ auch in einer Grafik darstellen will. (Nebenbemerkung: Werden solche Dinge eigentlich ausreichend dokumentiert, dass sie noch für unsere Nachkommen nachvollziehbar sind? Da empfehle ich die neue „Leihmutter/Samenspender-Suche“ auf Ancestry … sorry, Scherz) Aus meiner Sicht ist man dann mit einem Genogramm besser dran. Damit lassen sich beliebige Beziehungen darstellen wie z.B. „ist Nachbar von“, „ist Vorgesetzter von“ oder „ist Lehrer von“.

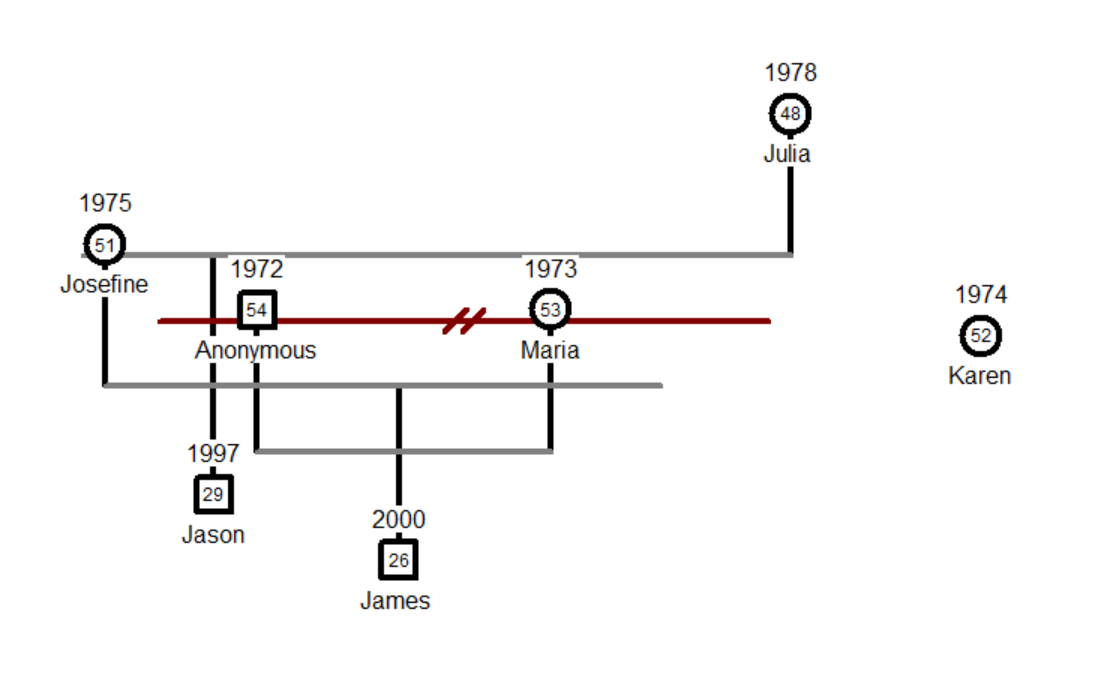
Ich habe daher die GEDCOM-Datei auch mal mit dem darauf spezialisierten Programm GenoPro darstellen lassen.

Ich bin aber vom Ergebnis etwas enttäuscht, da Gregor fehlt (und nicht etwa die Einzelperson Karen) und die Darstellung nicht eingängig verständlich ist. Aber vielleicht bin ich nicht GenoPro-Spezialist genug, um die Software vollends auszureizen.

@Hermann.Hartenthaler : Kleine Zusatzfrage: Wurde deine GEDCOM mit der „Standard-Oberfläche“ von webtrees erstellt oder mit der Funktion „GEDCOM Rohdaten bearbeiten“?

Gruß, Dirk

2 „Gefällt mir“

Noch anders: Ich habe den (englischen) Szenario-Text an eine KI (Claude) übergeben und mir GEDCOM erzeugen lassen (inkl. der Notizen). Das ging fix. Die GEDCOM-Datei habe ich dann in webtrees eingelesen und dort im Modus „GEDCOM Rohdaten bearbeiten“ verbessert, da sie syntaktische Fehler enthielt.

  • im FAM-Datensatz stand MOTH statt WIFE (soll wohl „mother“ bedeuten)
  • es fehlten alle Rückverweise (in den FAM waren Eltern und Kinder genannt, aber bei den INDI fehlten die Verweise auf die FAM, also die FAMC und FAMS)
  • die Adoption von James war nicht ganz korrekt in GEDCOM abgebildet

Damit war ich nach 15 Minuten fertig. Die webtrees-GEDCOM-Fehlersuche zeigte dann keine Fehler mehr an.

Da in der Szenario-Beschreibung keine Datumsangaben vorkamen, ich aber etwas Plausibles haben wollte, habe ich in der Standard-Bedienoberfläche von webtrees die Geburts-, Heirats-, Scheidungs- und Wohnsitz-Datumsangaben nachgetragen. Dann habe ich mit einem ganz neuen Erweiterungsmodul in webtrees die inhaltliche Plausibilität geprüft, da kamen dann nur Hinweise, dass es an Quellenangaben mangelt.

Zu Deinen inhaltlichen Ausführungen: da bin ich voll bei Dir. Danke auch für den leider etwas enttäuschenden Versuch mit GenoPro. Irgendetwas in der Art braucht man als grafische Darstellung komplexer Strukturen.

Man sieht schon, dass GEDCOM ein paar Probleme bereitet, etwa die zeitliche Darstellung von Pflegebeziehungen oder das Modellieren des Zusammenlebens in einer Patchwork-Familie (über RESI) ist unbefriedigend. Auch die Darstellung der Adoption als Familienstruktur und gleichzeitig als Event ist eigentlich schräg. Mal ganz abgesehen von den exotischen Dingen wie Leihmutterschaft.

Ich wollte den Diskussionsführer im Gramps-Forum dazu bringen, dass er aus dem Jammern und Schimpfen über GEDCOM rauskommt und mal etwas macht. GEDCOM oder Gramps XML verbessern wollte er nicht, sondern er will grundsätzlicher rangehen. Warum nicht? Ich bin ggf. als Sparrings-Partner dabei.

Deine Verwandtschaftstafel in Ahnenblatt ist übersichtlich, aber tatsächlich fehlt mir da die Möglichkeit mehrere Elternbeziehungen zu sehen. Meine Abbildung oben ist mit dem webtrees-Erweiterungsmodul GVExport erstellt worden (das kennt zwei Modi: einmal die gezeigte Version bei der Personen und Familien als Knoten auseinander gerissen sind und dann eine Version bei der Eltern/Partner zusammen als Familie in einem Kästchen stehen, was dann aber ggf. erfordert, dass Personen doppelt (in zwei Familienkästchen) dargestellt werden müssen.

Es gibt übrigens einen Diskussionsvorschlag für GEDCOM 8, der das Konstrukt Familie (FAM) eventuell auflöst und durch komplexere Konzepte (Zugehörigkeit zu Gruppen) ersetzt. Sehr interessant ist der eher evidenzbasierte und stark auf Ereignisse fokussierte Ansatz:

Ich bin über VisAC gestolpert…
das kriegt man mit ChatGpt, oder noch besser antigravity von google wunderbar zum laufen…
man braucht nur eine gedcom als datenbasis…
Damit spürt man auch wunderbar Ahnenschwund im eigenen Stammbaum auf, den man vielleicht noch gar nicht entdeckt hat…

Eine Variante die da rausfällt sieht dann ungefähr so aus…
Nennt sich contextual family tree… die boxen symbolisieren die lebensspanne, darunter die Kinder, getrennt nach Lebenszeit, als Kleinkind verstorben, als Kind, erwachsenenalter erreicht… Pfeile zeigen an ob die Kinder Kinder aben oder nicht (umgekehrtes Dreieck)

Hier kann man schön erkennen, dass Philipp IV die Tochter seiner Schwester geheiratet hat…
Die Visualisierung des Altersunterschieds und die Pfeile helfen…

2 „Gefällt mir“

Vielen Dank für diese beiden neuen Diagrammwerkzeuge! Beide sind hier neu. VisAC Muss ich unbedingt ausprobieren.

Hallo zusammen
Dieses Programm wurde in der Statistik Software R (R - Projekt) programmiert. Dies ist eine kostenfreie Software, die in wissenschaftlichen Kreisen weit verbreitet ist.
Die Installation gestaltet sich allerdings etwas schwieriger, wie es von klassischen Programmen gewohnt ist.
Man muss sich zunächst die aktuelle Version von R runterladen.
Und muss dann nach und nach manuell einzelne sogenannte Pakete herunterladen und installieren.
Das ganze kann im User Interface Rgui.exe erfolgen. Das im obigen Link bereitgestellte Paket muss ebenfalls installiert werden.

Um das Ganze zum Laufen zu bringen, ist ChatGPT oder ein anderes Sprachmodell sehr hilfreich. Ich selbst habe die kostenfreie Software Antigravity von Google genutzt die sogar Fehler Meldungen automatisiert lesen und entsprechende korrigierede Maßnahmen einleiten kann.

Dirk Zabel

Ich wollte R immer schon mal ausprobieren. Die Verlustlisten des 1. Weltkriegs sind in einer csv Datei publiziert worden.

Aber Excel kann mit 8 Mio Zeilen nicht umgehen. R kann das.

Moin an alle,

  1. eine große Tabellenkalkulation ist “Rowzero”, ( Pricing - Row Zero – the spreadsheet for modern cloud data ) die angeblich mit über 10 Millionen Zeilen umgehen kann. Sie ist cloudbasiert, englischsprachig und prinzipiell kostenpflichtig. Da hier nur eine Datei verwendet werden soll, könnte die kostenlose Version ausreichend sein.
  2. Da es sich eigentlich um eine Datenbank handelt und nicht um eine “Kalkulation” könnte auch das kostenlose “DruckDB” ( DuckDB – Wikipedia ) passen.

Ich habe beides nicht getestet.
Beste Grüße
Jörn (Knabbe)

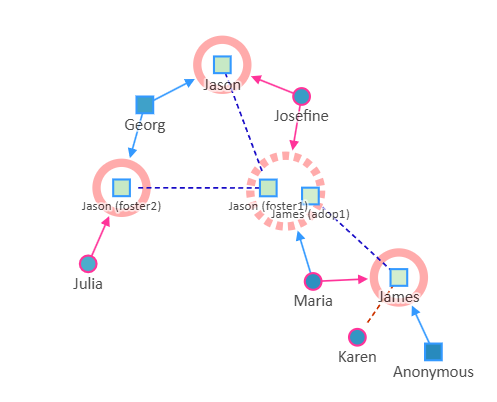
Es gibt ja diverse Visualisierungs-Tools für Webtrees, darunter auch 2 (von mir …), welche dynamische Node-Link-Diagramme generieren.

Oben: huhwt-wtTAM, unten: huhwt-wtLIN

Die aktuellen Versionen in GitHub können das noch nicht … Anmerkungen und Hinweise sind hochwillkommen.

Ernst Wolfgang Heinrich

@EW_Heinrich TAM und LIN sind hier ja schon mehrfach angesprochen worden (etwa ausführlich im Beitrag #5 und zuletzt von @GeorgFertig in #157).

Bis zu welcher Anzahl von Knoten und Kanten arbeiten diese Module? 10.000 kann ich bestätigen, 100.000 haben @GeorgFertig und @jzedlitz angefragt, hier zuletzt ging es um 10 Millionen, etwa in den Verlustlisten. Du hast doch auch die wissenschaftlichen Originalpublikationen gelesen. Gab es da Hinweise? Gibt es durch die Art Deiner Implementierung Grenzen?

Die Antwort ist ein klares - Öhm … Die Basis ist SVG, jedes Element der Darstellung ist jeweils auch ein oder sogar mehrere Elemente im DOM. Das unterliegende Verfahren - D3.js Force Simulation - ist durchaus rechenintensiv, ein kompletter Durchlauf - wenn also der ‘Heat’ Parameter von 1 auf 0.05 runtergeht - besteht aus ca. 300 Iterationen, in denen die Kräfte für jedes der dargestellten Elemente be- und verrechnet werden. Das macht sich bei höheren Knotenzahlen recht schnell bemerkbar. Es ist richtig, 10.000 Knoten sind darstellbar, das dauert dann aber auch pro Durchlauf durchaus lang und man muss eine ganze Reihe von Durchläufen absolvieren, um eine einigermaßen sinnvolle Darstellung zu bekommen. Für solche Zahlen braucht es eine leistungsfähige Plattform.

Man muss sich auch ehrlich fragen: Macht eine Force-Simulation-Darstellung für 10.000 Knoten und mehr wirklich Sinn? Es ist ja eben nicht eine Darstellung mit einem finalen Zustand, jede Veränderung, wenn man zum Beispiel an einem Knoten zieht, um ein Wirrwarr aufzudröseln, verändert den Zustand und das ganze “Bild” wird neu berechnet.

100.000 Knoten … ich habe kein entsprechendes Datenmaterial, mein Stammbaum hat nur ca. 10.000. Es kann sein, dass meine Hardware auch sowas stemmen könnte, aber ich habe erst kürzlich auf eine Maschine der neuesten Generation mit wirklich reichlich RAM umgestellt. Für einen Standardrechner dürfte das hinsichtlich der Performance nicht mehr darstellbar sein und wahrscheinlich kann auch ein aktueller Browser ein solches SVG-Konstrukt nicht wirklich verwalten.

Solche Knotenzahlen werden üblicherweise auch nicht als SVG-Komposite sondern über eine Canvas-Darstellung verarbeitet. Canvas heißt, dass es für den Browser nur ein Element gibt, welches er darstellen muss. Wie komplex die Szene darin dann ist, spielt für den Browser keine Rolle, das ist allein Sache der Anwendung. Das originale LINEAGE war Canvas-basiert. Das hat aber auch diverse Nachteile, denn es fehlt damit jegliche CSS-Unterstützung, die Navigation in der Darstellung - Drag’n’Drop, Zoom, Tooltip-Einblendung - ist schwierig in der Umsetzung und schon allein der Aufbau einer vielfältig differenzierten Ansicht wie wtLIN, wo ja diverse Farbwerte die Bandbreite der darin dargestellten Familiennamen präsentieren, ist reichlich umständlich. Deshalb hatte ich seinerzeit gerne auf SVG umgestellt.

Andererseits habe ich aber auch schon darüber nachgedacht, ob ich nicht doch versuchen sollte, wieder zurück zu einer Canvas-Ansicht zu gehen, eben wegen der Performance-Probleme, welche eine SVG-Darstellung von Knotenzahlen im 10.000er Bereich hat. Die unterliegende Simulation bleibt ja immer noch extrem aufwendig. Ob es gelingen kann, alle Optionen aus wtLIN mitzunehmen, ist fraglich. Es würde jedenfalls auf einen gewaltigen Umbau hinauslaufen.

Fazit: Für 20.000 Knoten kann wtLIN in derzeitiger Form noch funktionieren, steigt die Zahl darüber hinaus, dürfte das Verfahren an diverse Grenzen stoßen. Eine Umstellung zurück auf Canvas kann die Grenze vielleicht auf bis zu 100.000 schieben, allerdings werden dabei aus technischen Gründen manche Feature auf der Strecke bleiben müssen, weil sie mit einem Canvas nach meinem derzeitigen Kenntnisstand nicht realisierbar sind. Für deutlich darüber hinaus gehende Knotenzahlen ist das Verfahren meines Erachtens grundsätzlich nicht geeignet.

Antrieb meines Postings war eigentlich die in #160 ff gezeigte Darstellung. In der Diskussion wurde bemängelt, dass andere Verfahren nicht alle Sachverhalte mitgenommen bzw. nicht sinnvoll dargestellt haben.

Wie ist der Befund in Bezug auf wtTAM und wtLIN? Meine eigene Einschätzung geht dahin, dass die Familien-basierte Ansicht in wtTAM besser geeignet ist, solche komplexen Situationen optisch sinnvoll aufzubereiten.

Falls Detailinformationen vermisst werden - die werden als Tooltip-Window angezeigt, wenn der Mauszeiger über einem Knoten schwebt.

Ich bitte um Nachsicht, dass ich so spät reagiere …

Welche Art von Datenbestand soll dargestellt werden? Was soll mit der Ansicht herausgestellt werden?

wtTAM und wtLIN sind dynamisch, es gibt keinen wirklichen Endzustand. Einen Graph mit 100.000 Knoten und entsprechender Anzahl von Links (wahrscheinlich 200.000 oder noch mehr) kann das Verfahren in der aktuellen Ausprägung bestenfalls auf extrem leistungsfähiger Hardware sinnvoll bewältigen, wenn überhaupt.

Ich kann es wohl anders aufstellen, aber dabei werden verschiedene Feature eventuell technisch nicht mehr umsetzbar sein.

Welche Anforderungen muss ein Verfahren in Bezug auf die Dateninhalte erfüllen?

EW.Heinrich - huhwt

Ich hatte vor ein paar Tagen eine Idee dazu, die ich offenbar gar nicht hier aufgeschrieben habe, sondern nur mit @Hermann.Hartenthaler mündlich besprochen habe.

Es geht darum, richtig große, also beliebig große Stammbäume oder Verwandtschaftsnetze zu visualisieren. So dass man das ganze Ding sehen kann mit sechs- oder siebenstelligen Zahlen von Knoten, und aber auch so, dass man reinzoomen kann und die Details sieht.

Ich glaube, das gibt es bisher nicht. Man kann aber eine Darstellungsform nehmen, die wir ständig benutzen, nämlich bei Geodaten. Unser Geovis ist nicht ungewöhnlich: Zoome ich raus, sehe ich die grobe Anordnung, zoome ich rein, sehe ich die Details.

Statt Orten sind es hier Personen. Die Darstellung hätte zwei Dimensionen. Auf dem Breitengrad (nord-süd) die Zeit oder die Generation, ggf. interpoliert. Auf dem Längengrad (quer) die verwandtschaftliche Nähe, die man ebenfalls ausrechnen oder interpolieren kann. Zoomt man richtig rein, sollten nicht nur aggregierte Knoten zu sehen sein, sondern auch die einzelnen Kanten und Namen/Daten.

So dargestellt wären Personen in ihren Verwandtschaftsbeziehungen genauso darstellbar wie Orte auf einer Karte.

Die eine Achse, die Zeit, kann man mit LINEAGE bereits darstellen. Etwa statisch oder dynamisch über einen Slider mit dem man durch die Jahrzehnte fährt (bereits Verstorbene oder noch nicht Geborene sind dann unsichtbar). Das Geburtsdatum oder das Lebenszeit-Zentrum eignen sich hier gut zur Einordnung, notfalls wird es interpoliert.

Generell:

  • Knoten: Personen (INDI)

  • Kanten: Eltern-Kind- und Partner-Beziehungen (FAMC/FAMS)

Die andere Achse ist mir noch nicht klar. Was bedeutet “Verwandtschaftliche Nähe”? Was ist der Bezugspunkt?

In den Weltbäumen gibt es die Maßeinheit “Schritte”, sie ist durch die Entfernung in Schritten zwischen zwei Personen definiert. Ein Schritt ist die Distanz Elter/Kind oder Partner/Partner. Ein Enkelkind ist vom Probanden zwei Schritte weg, genau so weit ist es zum Schwager oder Schwägerin (sofern man Vollgeschwister als ein Schritt zählt, man kann sie aber auch als zwei Schritte zählen). Im Umkreis von 7 Schritten hat man bei guter Erforschtheit etwa 500 bis 1.000 Personen. Dieses System braucht aber den Probanden, der in der Zeit fixiert ist. Wenn es funktionieren soll, braucht man eine Definition von “Verwandtschaftlicher Nähe” ohne zeitlichen Bezug (Achsen müssen orthogonal sein). Die Nähe zum Probanden erzeugt ein radiales Fokusmaß. Man könnte nun den Probanden und seine väterlichen Vorfahren als Bezugspunkte festlegen, dann hätte man etwa alle 30 Jahre eine Referenzperson, von der aus man die Verwandtschaftliche Nähe messen kann. Das spannt dann tatsächlich eine Ebene auf. Aber zum einen gefällt mir nicht, dass das alles von einem Probanden abhängig ist und zum anderen, dass es in der Realität immer unverbundene Inseln gibt (man kennt ja nie alle Verbindungen), die dann alle unendlich weit entfernt sind.

Nun könnte man sich vom Probanden lösen und eine Distanzmatrix berechnen, die die Entfernung von jeder Person zu jeder anderen Person darstellt. Dabei kann man auch Ehen oder Adoptionen geringer gewichten als biologische Verbindungen. In dieser Matrix kann man Familien, Großfamilien und Clans identifizieren, die man per Zoom aggregieren oder auflösen kann. Das löst aber immer noch nicht die Frage, wie man das auf einer Achse anordnen soll.

In Programmen zur Netzwerkanalyse wie Pajek kann man Gedcom-Dateien ja auch als Netzwerk einlesen. Insofern ist die Art, wie dort geclustert und graphisch dargestellt wird, vergleichbar. Was dann wie zusammengestellt wird, ist in der Netzwerkanalyse ziemlich willkürlich. Was im Netzwerk näher dran ist, wird zusammengeschoben, was weiter weg ist, auseinander. Iterativ, bis es hübsch aussieht.

Die Definition von Distanz (bzw. umgekehrt closeness) ist einfach die minimale Zahl der Schritte zwischen zwei Knoten.

Übertragen auf genealogische Netze würde ich die Frage für die jüngste Zeitschicht (Generation) so stellen: Ordne die Knoten so an, dass die Summe der geometrischen Distanzen so wenig wie möglich von der Summe der Netzwerkdistanzen abweicht. Für die Netzwerkdistanzen werden dabei auch Pfade rauf und runter über alle Generationen berücksichtigt.

Dabei muss man noch auf Kontinuität über die Zeit achten. Wenn ich die jüngste Generation angeordnet habe, dann werden die Koordinaten für die nächstältere Generation unter Berücksichtigung der bereits festen Positionen in der jüngsten Generation festgelegt.

Inseln können dann rein zufällig verteilt werden.

Das macht etwa TAM mit einer Kräfte-Simulation (Abstoßung und Anziehung). Eine solche Simulation ordnet in der Ebene nach verwandtschaftlicher Nähe. Leider skaliert das mit O(n^2), also nicht gut für sehr große Netze, und das Ergebnis des Knäuls ist nicht deterministisch. Aber es gibt natürlich noch andere Abbildungen.

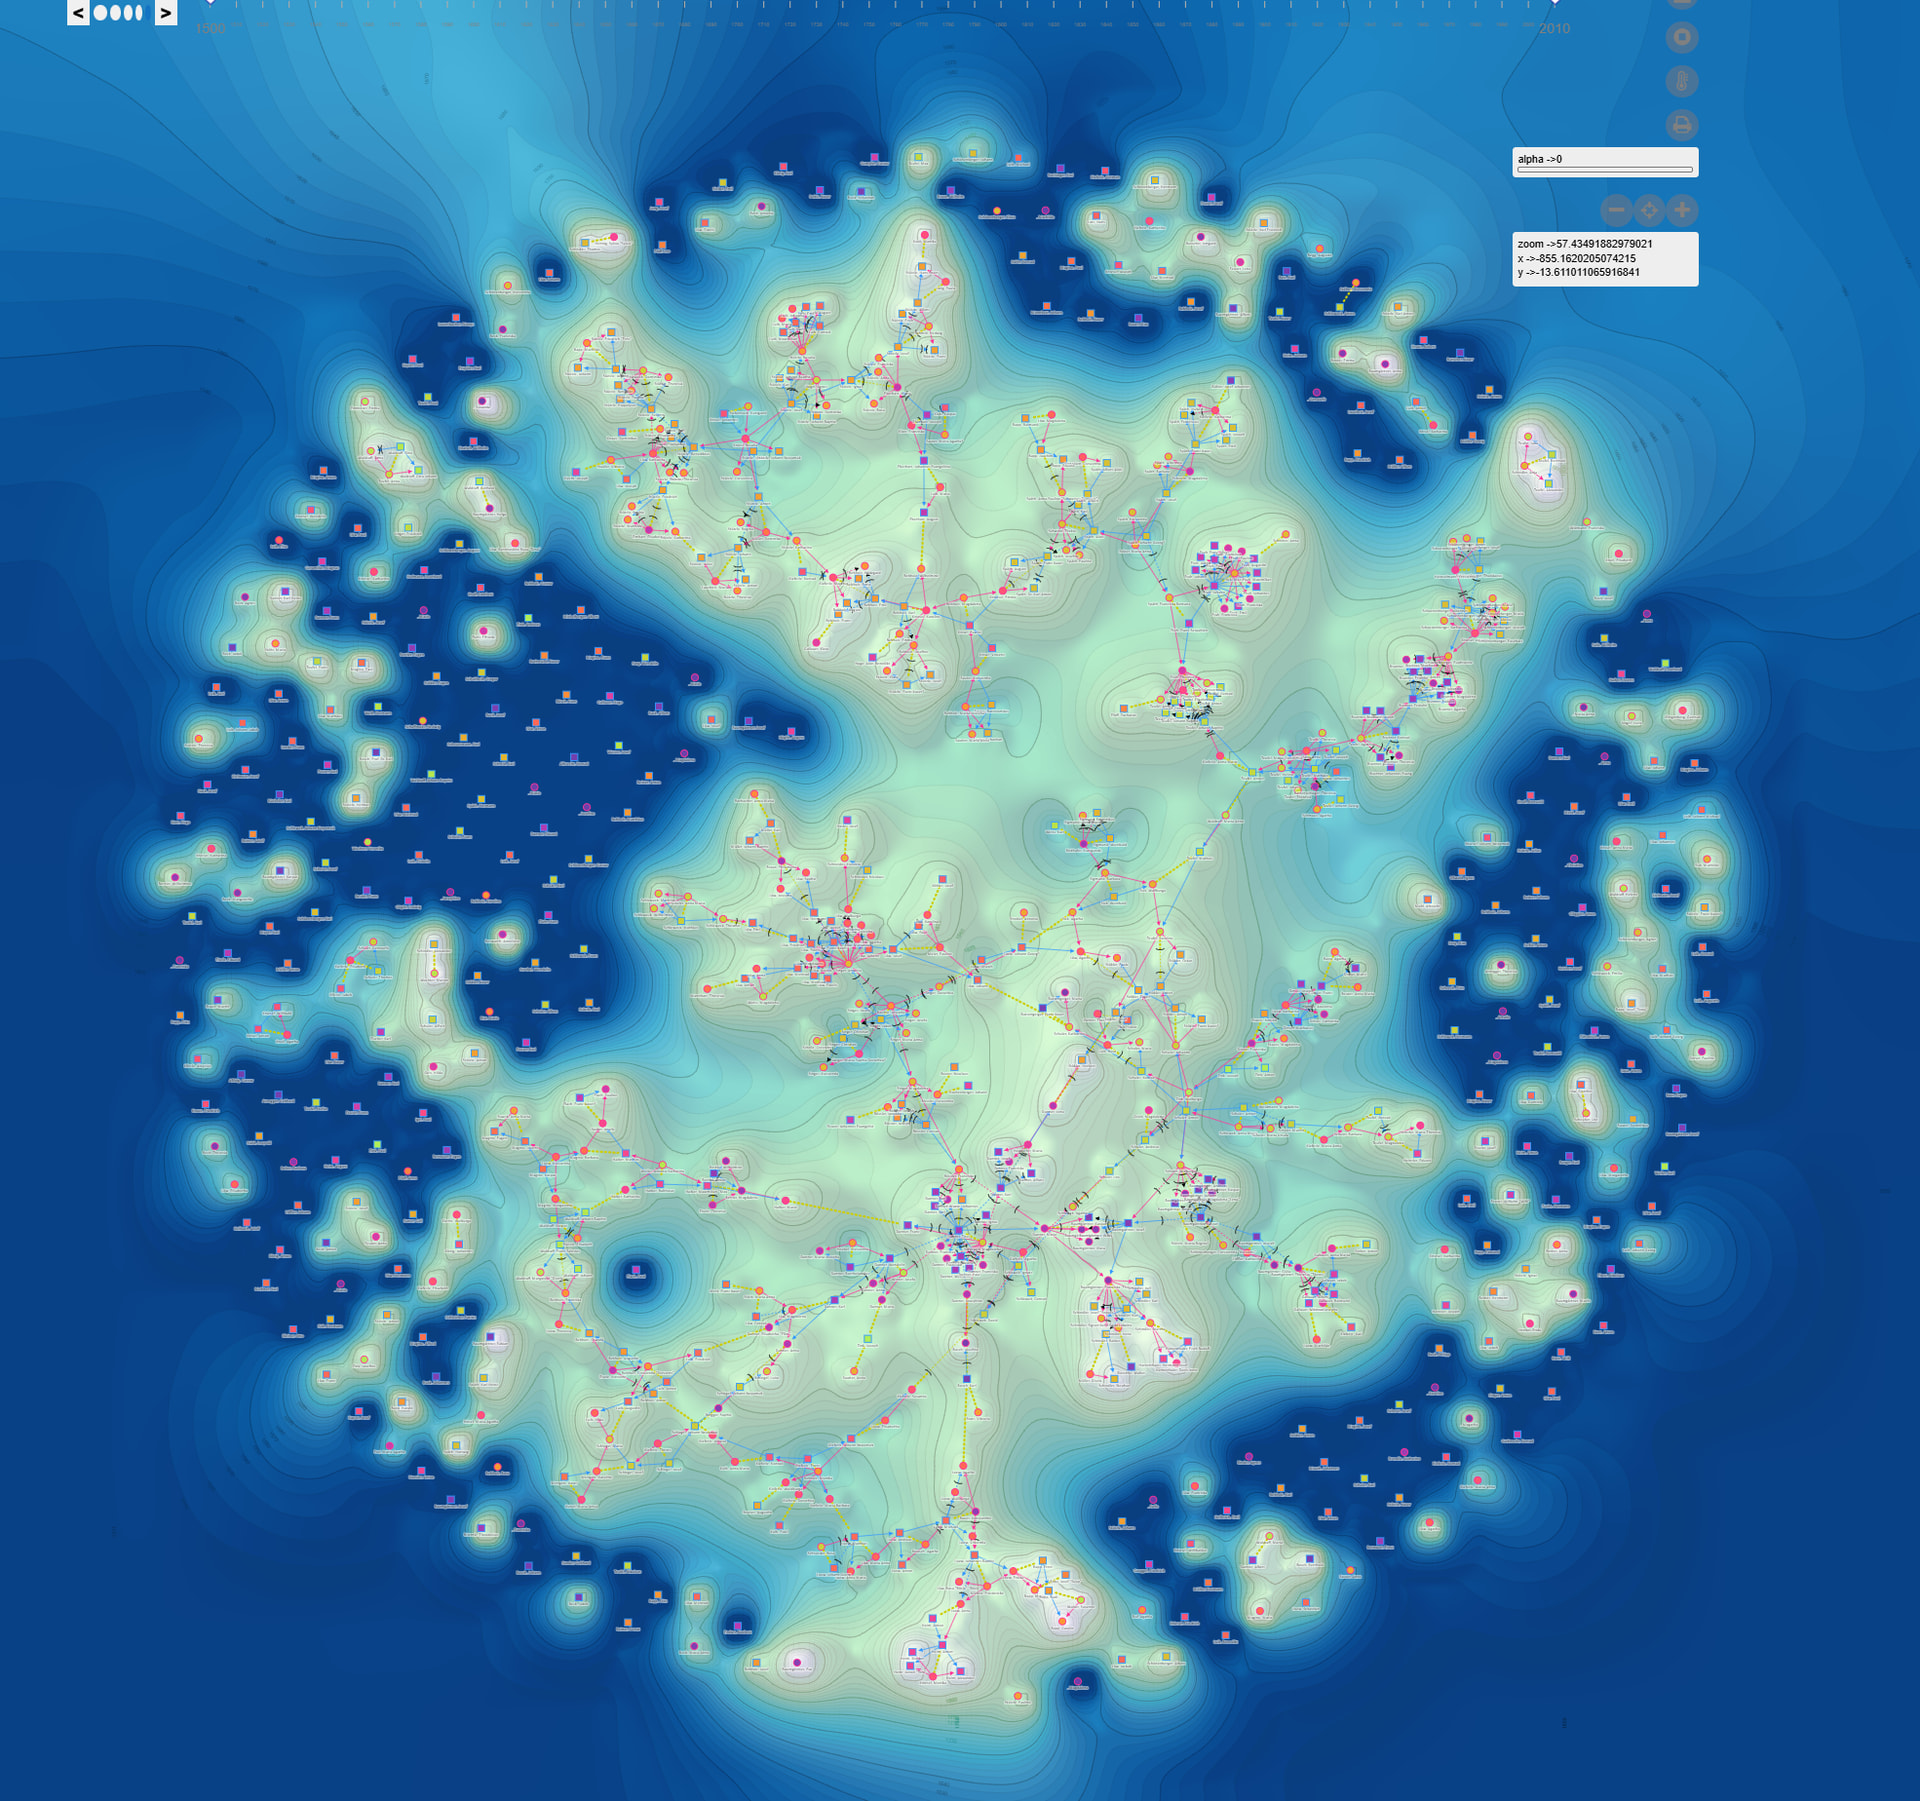
Hier einmal eine Darstellung in webtrees mit LINeage mit den von mir erfassten etwa 1.660 Einwohnern des Heimatdorfes meiner Mutter (von 1500 bis heute): Ennetach.

Eine andere Darstellung in LINeage ist die 2D-Ansicht mit temporalen Höhenlinien (man sieht relativ viele Einzelpersonen; das sind Personen aus einem Adressbuch meist ohne Geburts-/Todesdaten, die hier zeitlich vor 1500, am Meeresgrund quasi, dargestellt werden):

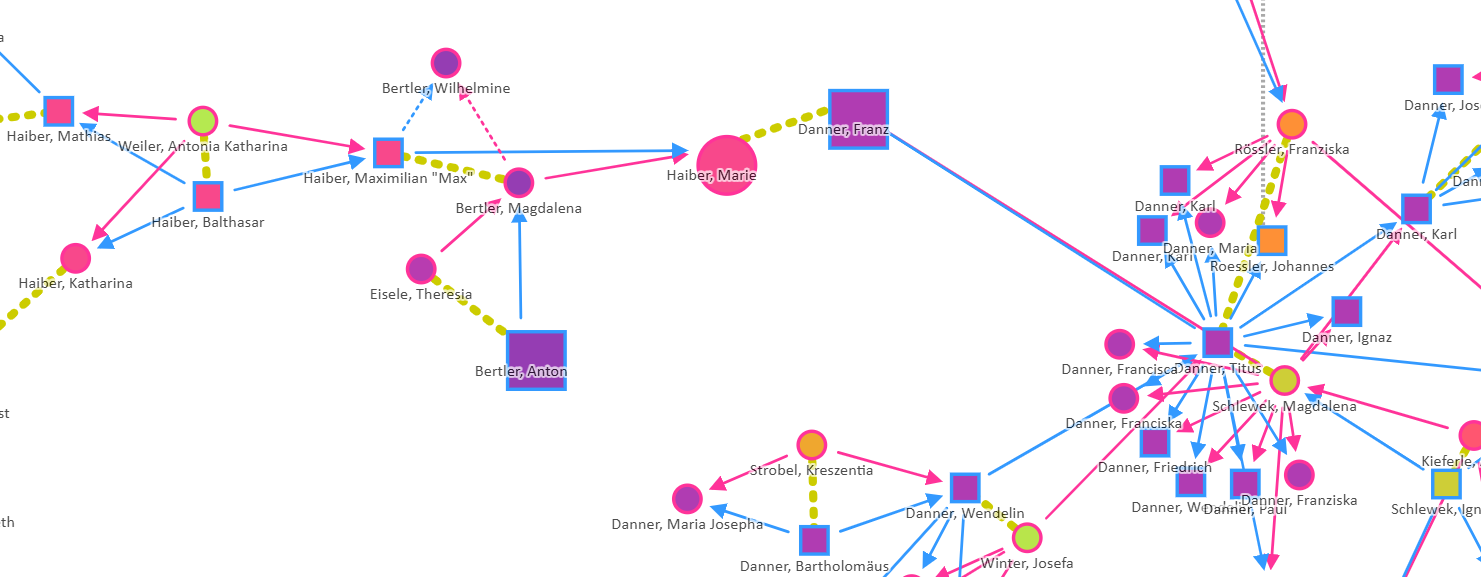
Wenn man reinzoomt kann man die Familien sehen (hier nur ein kleiner Ausschnitt ohne die Höhenlinien):

Die gelben gestrichelten Linien sind die Heiratsbeziehungen, blaue Pfeile gehen vom Vater zum Kind, rote Linien von der Mutter zum Kind.